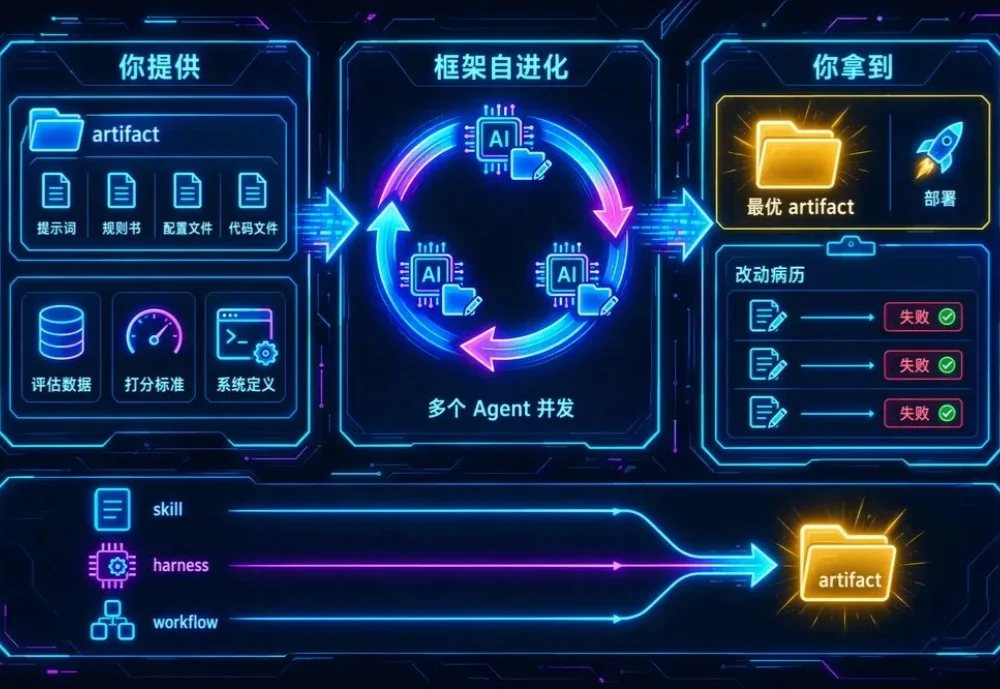
效果上不去?蚂蚁把「调AI」这件事,也交给了AI
效果上不去?蚂蚁把「调AI」这件事,也交给了AI每个做 AI 系统的人都经历过这个阶段:效果上不去,又不知道往哪使劲——读轨迹、改 prompt、调配置,靠人一轮轮试,一试就是好几天。
来自主题: AI技术研报
8354 点击 2026-10-29 11:25

 搜索
每个做 AI 系统的人都经历过这个阶段:效果上不去,又不知道往哪使劲——读轨迹、改 prompt、调配置,靠人一轮轮试,一试就是好几天。
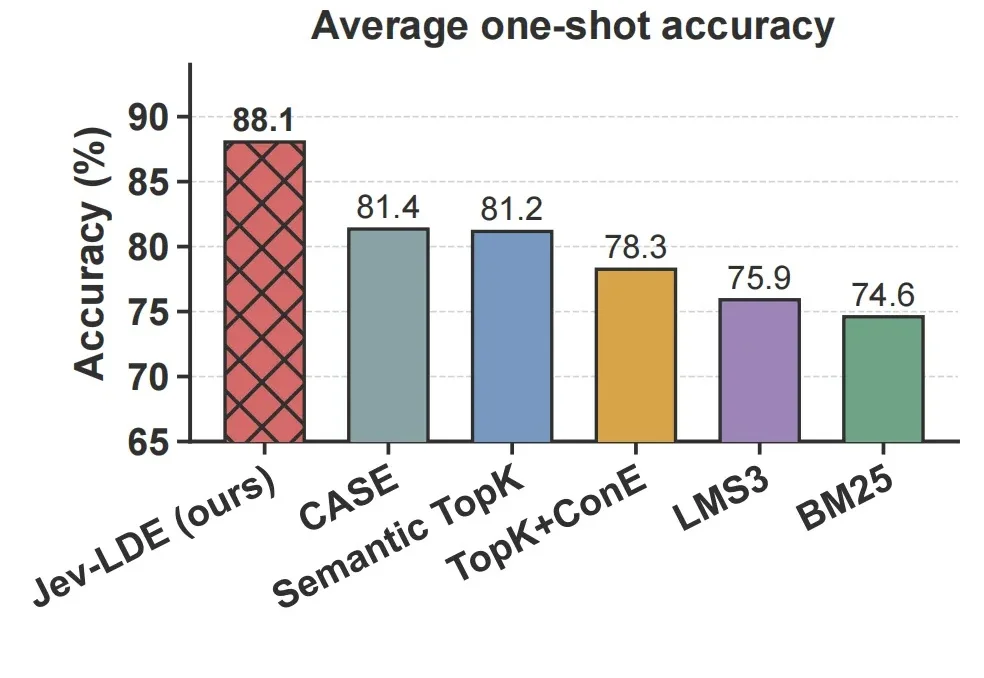
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
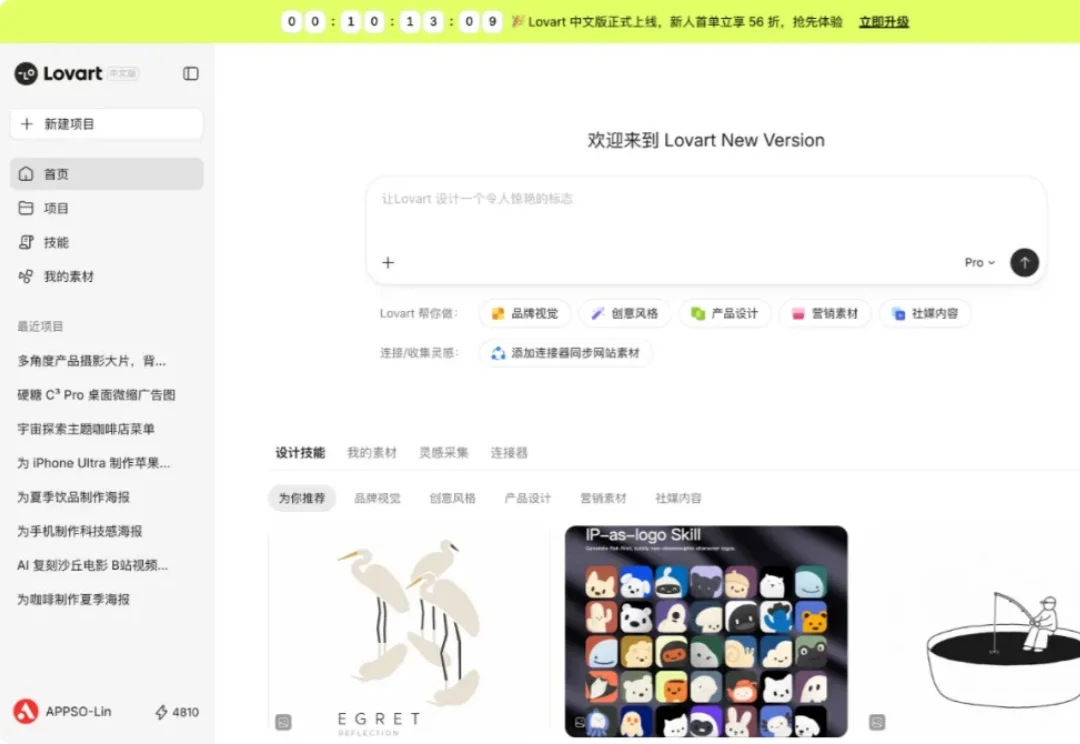
现在的 AI 生图有点太强,像 images 2.0 这样的模型,一段 Prompt 敲进去,直接逼真到你怀疑现实的一切。
最近来自斯坦福大学、CMU、MIT、UT Austin 等高校和科研机构的研究人员联合发布了全球首个系统提示词库 System Prompt Index(systempromptindex.ai),其中汇集了来自 Claude、ChatGPT 等 400 多款 AI 产品的 1000 余个系统提示词,是目前全球规模最大的 AI 系统提示词库。
本文作者 Eric Provencher,在 OpenAI 负责 Codex 开发者体验(DX),此前是 Repo Prompt 的作者。原文是 OpenAI 官方文档中的 Prompting 指南,以下为逐段中英对照翻译
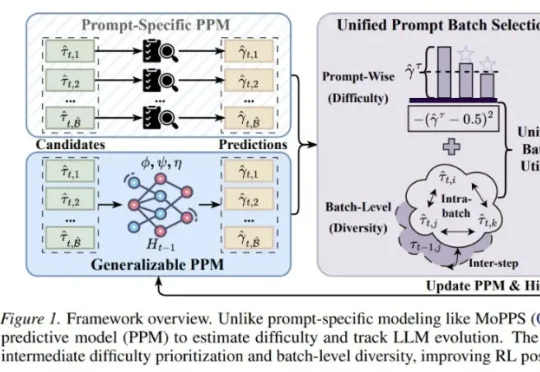
来自清华大学与腾讯的研究者提出了 Generalizable Predictive Prompt Selection(GPS)。GPS 的做法很直接:先训练一个小型、可泛化的 Prompt Predictive Model(PPM),让它预测不同 prompt 在当前模型下的难度;再根据难度和 batch 多样性选择训练样本,从而减少无效 rollout。
整个周末我都在把额度刷刷刷满,剩下最后20%的时候在X上看到一个开发者发的一条长贴,他说他把Fable 5的行为模式,再结合Claude团队开源的Fable5提示语技巧,提炼成了一份协议,贴给Opus 4.8用,神人来的。
这就是最近网上热传热议,然后老黄黄仁勋给AI新趋势画的新重点:Nobody writes prompts anymore. The new job is to write and handle loops.(现在根本没有人写Prompt了,新时代的核心工作是编写和管理loop。)
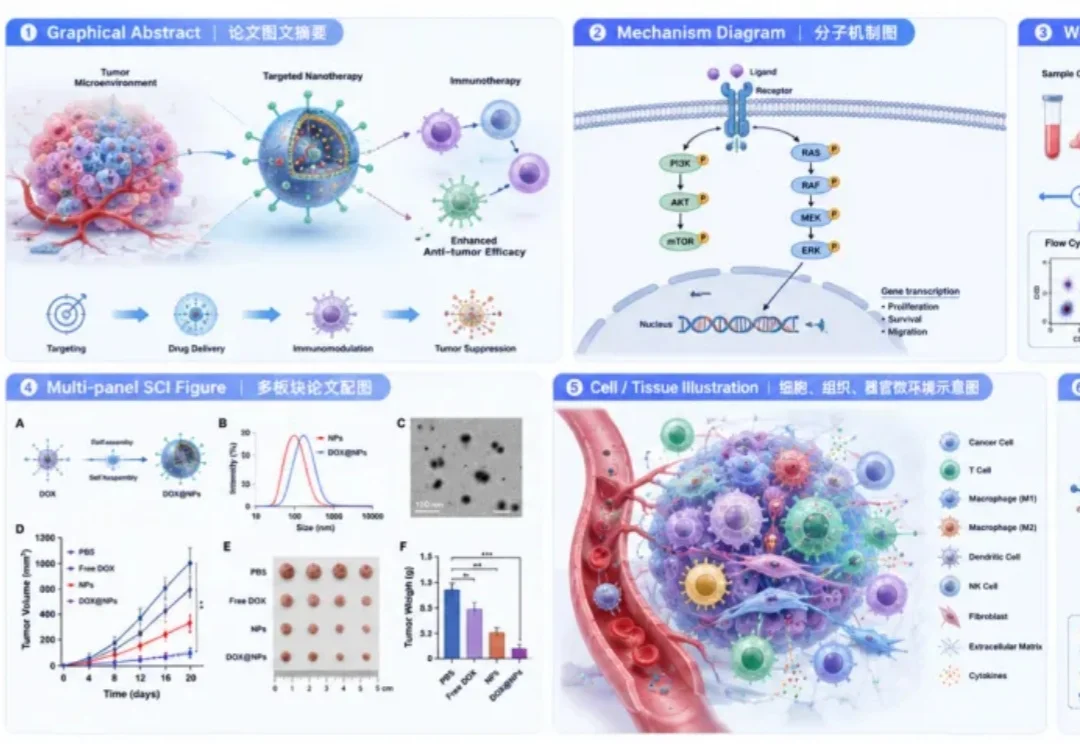
做科研的人应该都懂,论文配图真的很耗时间。
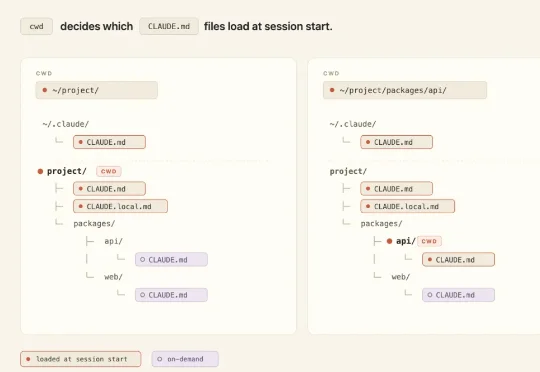
在常规的对话外,Claude Code(也可以是 Codex)其实还提供了一些别样的控制(或者说:上下文注入)方法,比如:CLAUDE.md、Rules、Skills、Subagents、Hooks、Output Styles、以及 System Prompt Append